イヤホン型AI「Plaud One」が年内国内発売へ!契約不要eSIM内蔵で話すだけで資料作成も
2026/10/24 02:04:34
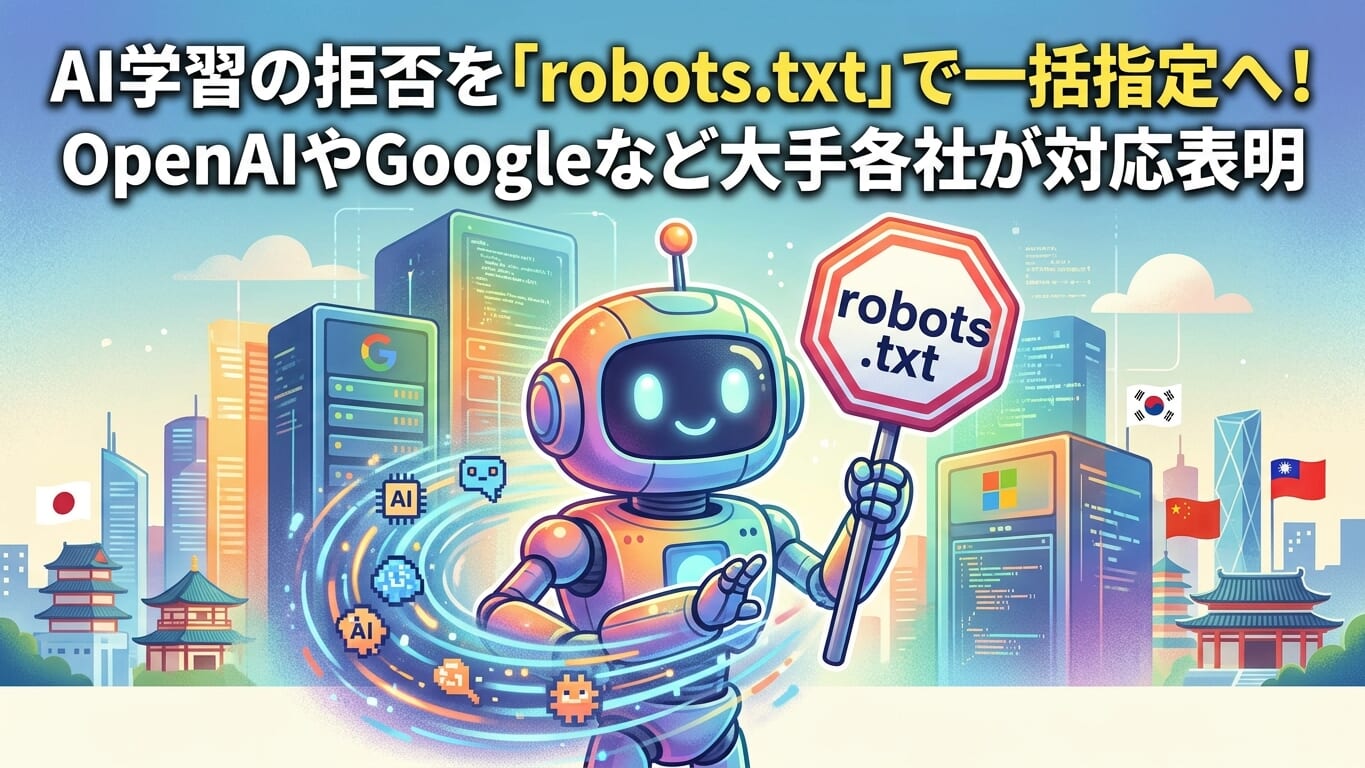
Webサイトのコンテンツが生成AIの学習データとして無断で利用される問題について、大きな進展が見られました。Webサイトの設定ファイル「robots.txt」を活用し、AIによる学習を一括して拒否できる共通仕様に、大手テクノロジー企業が足並みを揃えています。
今回の枠組みには、OpenAIをはじめ、GoogleやマイクロソフトといったAI業界を牽引する主要各社が対応を表明しました。これにより、サイト運営者はよりシンプルかつ確実に自らのコンテンツの学習利用をコントロールできるようになる見込みです。
生成AIの急速な普及に伴い、ネット上のテキストや画像などのコンテンツが開発企業によって学習データとして収集される事例が増加しています。これに対し、多くのWebサイト運営者やクリエイターの間では、許可のないデータ利用に対する懸念や反発が広がっていました。
これまでも検索エンジンの巡回を制御する「robots.txt」を用いてAIのクローラー(情報収集プログラム)を個別に遮断する方法は存在していましたが、開発企業やサービスごとに指定方法が異なり、運営者側の管理負担が非常に大きいという課題がありました。
今回の取り組みの大きなポイントは、複数の主要AI企業が共通のルールに合意し、一括で学習拒否の意思表示を行える仕組みを導入した点にあります。
OpenAI、Google、マイクロソフトといった巨大テック企業が足並みを揃えて対応を表明したことで、標準的な制御方法としての実効性が大幅に高まりました。サイト運営者は単一の標準化された記述を行うだけで、主要なAIモデルによる学習を一律に制御できるようになります。
AI技術の発展とクリエイターやWeb管理者の権利保護のバランスを巡る議論は、世界中で活発に行われています。
大手各社が共通ルールに賛同したことは、Web上のデータ収集においてサイト側の意思を尊重する重要な一歩となります。今後、他のAI開発企業やクローラーにもこの共通仕様への準拠が広がるかが注目されます。
ゴゴ通をフォローする



2026/10/24 02:04:34
2026/10/12 01:02:21
2026/10/12 06:33:27
2026/10/08 08:35:11
2026/10/07 03:05:14
2026/10/06 12:25:32
2026/10/05 04:03:45
2026/10/05 03:03:45
2026/10/05 08:33:45
2026/10/05 12:50:49
2026/11/01 19:03:37
2026/11/01 18:04:04
2026/11/01 17:03:38
2026/11/01 16:03:45
2026/11/01 15:03:49
2026/11/01 14:03:47
2026/11/01 13:03:29
2026/11/01 12:03:47
2026/11/01 11:03:32
2026/11/01 10:03:27